热力学性质计算
计算分子热力学参数及反应平衡性质
已激活请计算 {system} 的热力学性质。(1) 计算标准焓、熵与吉布斯自由能;(2) 计算 {temperature} 下的平衡常数;(3) 在温度范围内生成范特霍夫图;(4) 判断反应的自发性与可行性;(5) 若提供动力学数据则估算活化能;(6) 与文献实验值进行对比。
复杂科研,不止需要答案。
还需要证据、验证与反复推演。
立理 S1 可持续工作 100 小时,
直到每一个结论都有理有据。
立理 S1 基于Graph Engineering 图工程构建,将规划、编码、实验、评审等科研环节组织为一张可循环、可回退的智能体协作图。不同问题会被精确退回对应节点重新执行,已验证结果持续保留;所有智能体共享完整研究上下文,并通过独立评审与真实沙箱执行验证结果,让复杂科研任务在长时间运行中依然保持连续、严谨与可控。
成熟的科研方法,不必每次从头设计。
立理 S1 将不同领域的研究方法、分析流程与质量标准封装为 300+ 专业科研工作流。从论文评审、单细胞分析,到分子对接、晶体结构预测与 CFD 仿真,每一条工作流都定义了完整的执行路径与验证标准。
你只需要提供研究目标、数据或必要参数。S1 会自动选择并调用所需 Skills,完成计算、分析、验证与结果整理。
同一套方法,可以被反复执行、追踪和复现。让复杂研究拥有稳定的方法,也拥有稳定的结果。
计算分子热力学参数及反应平衡性质
已激活请计算 {system} 的热力学性质。(1) 计算标准焓、熵与吉布斯自由能;(2) 计算 {temperature} 下的平衡常数;(3) 在温度范围内生成范特霍夫图;(4) 判断反应的自发性与可行性;(5) 若提供动力学数据则估算活化能;(6) 与文献实验值进行对比。
每一个 Skill 都将专业方法、代码工具、数据源与验证规则封装为一项可直接执行的科研能力。
从文献检索、数据分析、统计建模,到单细胞分析、分子计算、机器学习与出版级制图,S1 的 Skills 还可直接连接0+个专业科学数据库,在研究过程中获取真实数据、调用专业工具并完成计算与验证。
你可以主动选择需要的 Skills,也可以交给 S1 根据任务自主判断、组合与调用。
科研实验需要的不只有模型,也需要真正可运行的计算环境。
立理 S1 内置智能算力基础设施,通过算力池与预热调度,让智能体需要计算资源时可以秒级启动 CPU / GPU 沙箱,同时获得更低成本的算力供给。
常用科研环境、开发工具与依赖预置在沙箱中,从数据分析、科学计算到机器学习实验,打开即可运行,大幅减少找机器、排队、安装环境和配置依赖的时间。
预热算力池,智能体随时可以开始计算
常用框架、工具与依赖开箱即用
环境、中间产物与实验状态持续保存
每个任务拥有隔离的代码与数据环境
根据实验需求选择 CPU、GPU 与对应规格。后台持续进行资源调度与实例预热,在保障可用性的同时降低算力成本。
面向科研,充分发挥国产旗舰模型能力。
S1 原生接入 Kimi K3、DeepSeek V4 Pro、Qwen 3.8 Max、GLM 5.3、MiniMax M3、DeepSeek V4 Flash 等国产旗舰模型,并针对科研长程任务、代码执行与复杂推理场景持续优化。
用户可根据任务难度、性能需求与预算自由选择模型,在保证科研能力的同时,更灵活地控制使用成本。
来自立理 S1 的实际研究任务。每个案例都可查看研究成果、执行过程和完整会话。

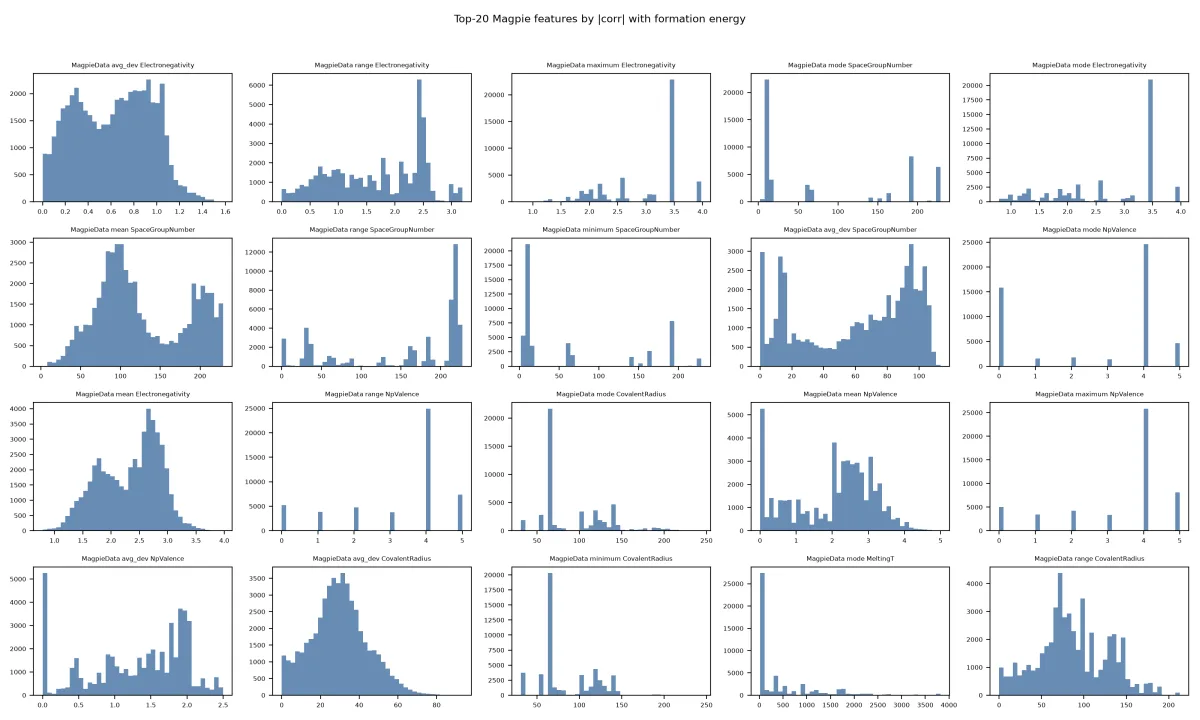
本研究构建了一套纯成分特征驱动的轻量级 CPU 级机器学习基准,旨在无需晶体结构信息的条件下评估材料形成能(ΔEform)的预测性能。研究系统对比了随机森林(RF)、XGBoost(XGB)与 RBF 核脊回归(KRR)在随机插值与留元外推(LOO)情境下的表征能力,揭示了树集成模型与核回归模型在化学空间外推上的根本差异。

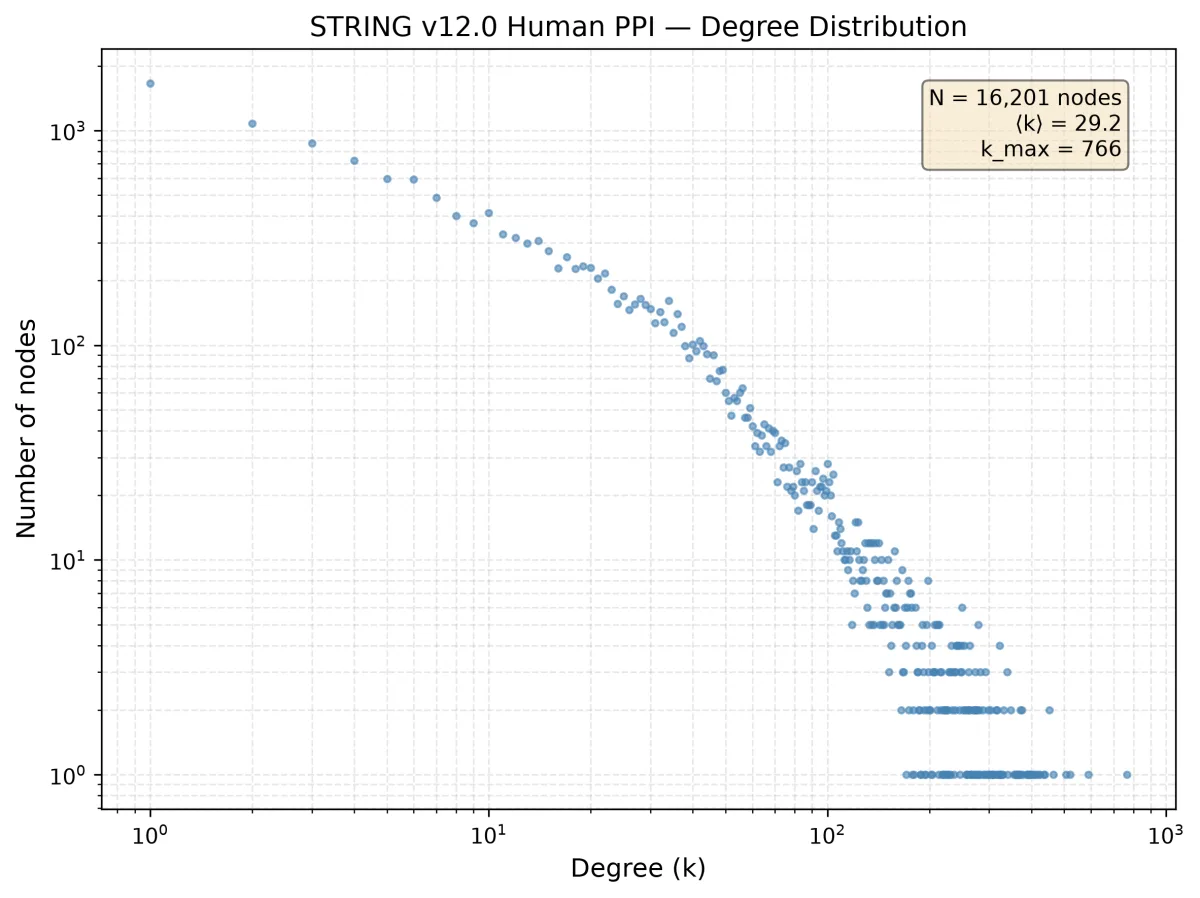
本研究旨在评估仅依靠网络拓扑特征预测人类蛋白质相互作用的可行性与边界,通过构建基于 STRING 数据库的万级网络并提取 6 种拓扑指标,对比了多种机器学习模型的预测效能,发现线性逻辑回归与正则化 XGBoost 均能实现优异的预测性能(AUROC > 0.97),且资源分配指数在预测中占据主导地位。

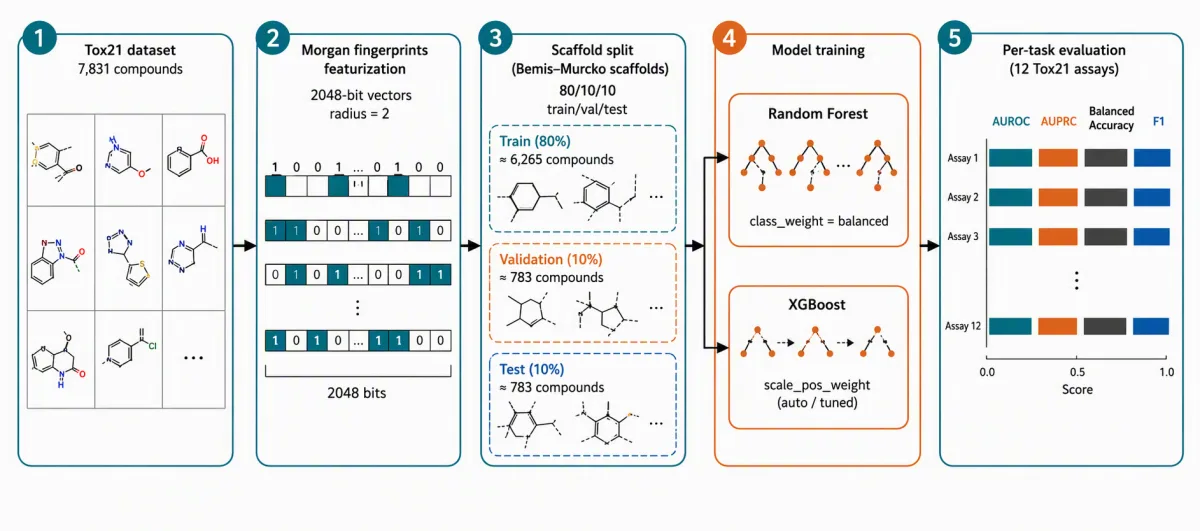
本研究旨在评估传统分子指纹与树集成模型在化学毒性筛选中的预测表现。研究基于分子骨架拆分构建严苛验证基准,对比了随机森林与XGBoost在12项毒性终点上的排序性能与二分类决策表现。

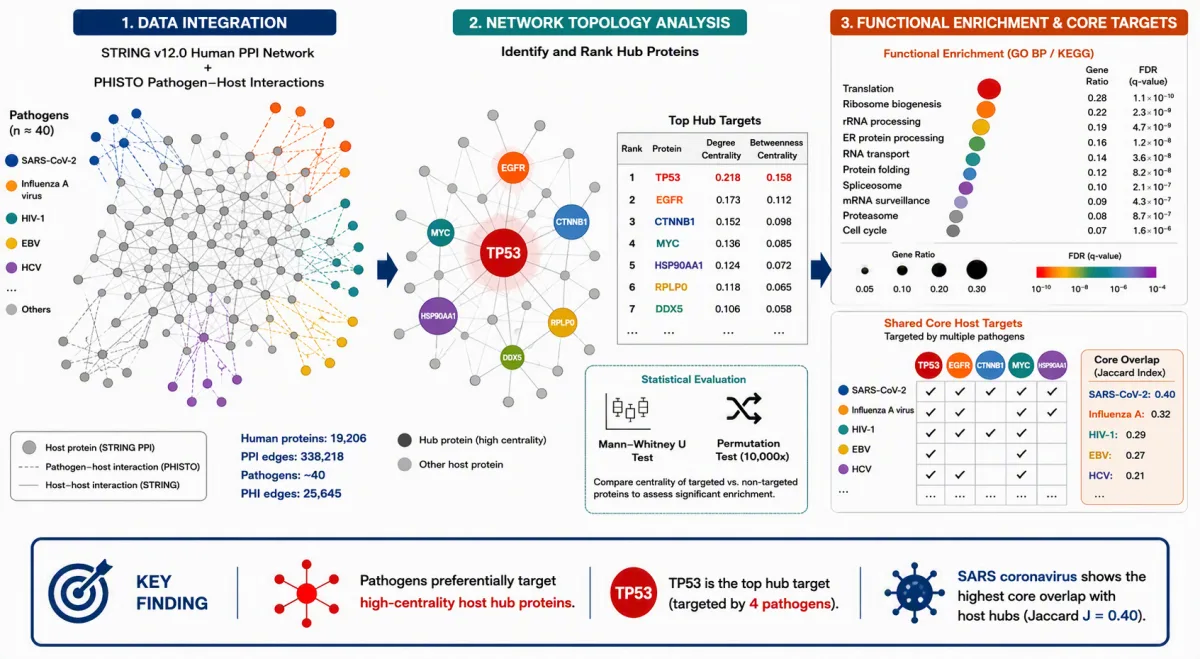
针对病原体如何通过分子接口重构宿主蛋白相互作用网络的问题,本研究通过整合STRING v12.0人类蛋白相互作用背景网与包含156种病原体的PHISTO数据库,系统解析了病原体靶向宿主蛋白的拓扑与功能特征。研究表明病原体显著偏好靶向高度数与高介数中心性的核心枢纽蛋白,并收敛于翻译、核糖体及内质网蛋白加工等核心功能模块;TP53被识别为最高中心性的靶向枢纽,DLG1为最广谱的受累宿主蛋白。该研究为理解跨病原体利用宿主网络的通用逻辑及开发广谱宿主靶向治疗策略提供了网络生物学依据。

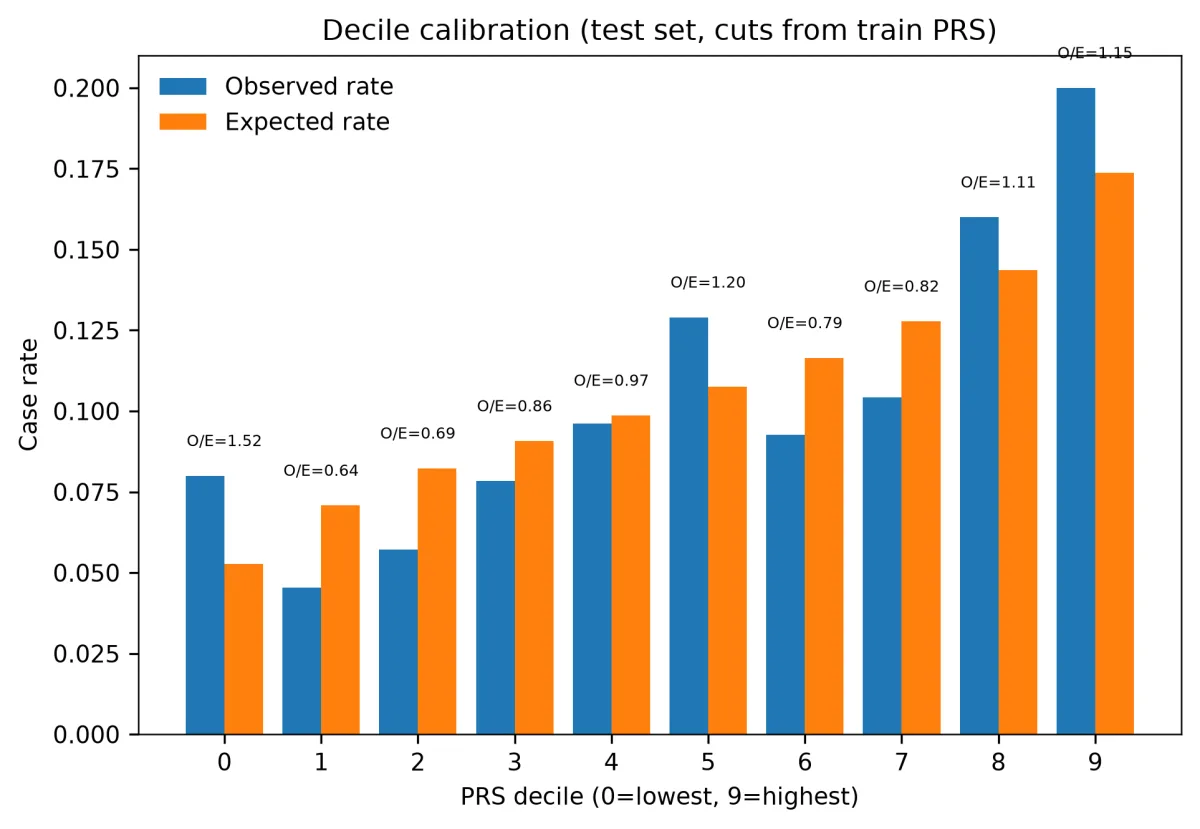
在多基因风险评分(PRS)迈向临床应用之前,针对其计算流程中由于基因组版本不匹配、位点对齐错误或等位基因反转引发的“隐性故障”问题,本研究基于PGS Catalog开源评分PGS000018(metaGRS_CAD)与千人基因组计划(1000 Genomes)参考面板,建立了一套透明且可重复的端到端计算流程验证方案。通过注入由PRS直接生成的合成表型,本研究完成了流程的非平庸性自检、校准度检验与跨人群移植性评估,证实该计算流水线已具备处理真实临床表型数据的能力。

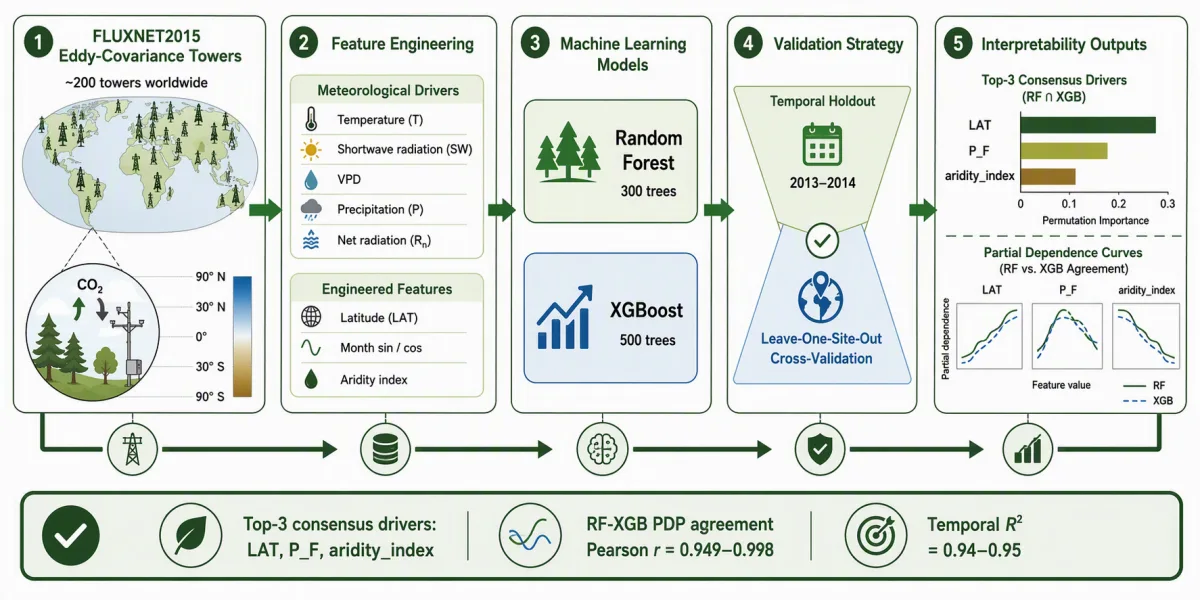
针对陆地生态系统总初级生产力(GPP)在月度与站点尺度上因气象驱动因子非线性交互作用而难以精确预测的问题,本研究基于涵盖2000—2014年约200个全球涡度相关通量站的数据,开发了结合气象因子、地理坐标与干旱指数的随机森林与XGBoost回归模型。在严控泄漏的时空评估框架下,XGBoost在时间留出集上实现了0.950的$R^2$,但在跨站点迁移(LOSO-CV)中降至0.31—0.39。结合模型可解释性分析(PDP/ICE),研究揭示了地理与长期水热平衡对跨站变异的主导作用,并证实树状集成模型重现了光利用效率模型的经典非线性响应曲面。

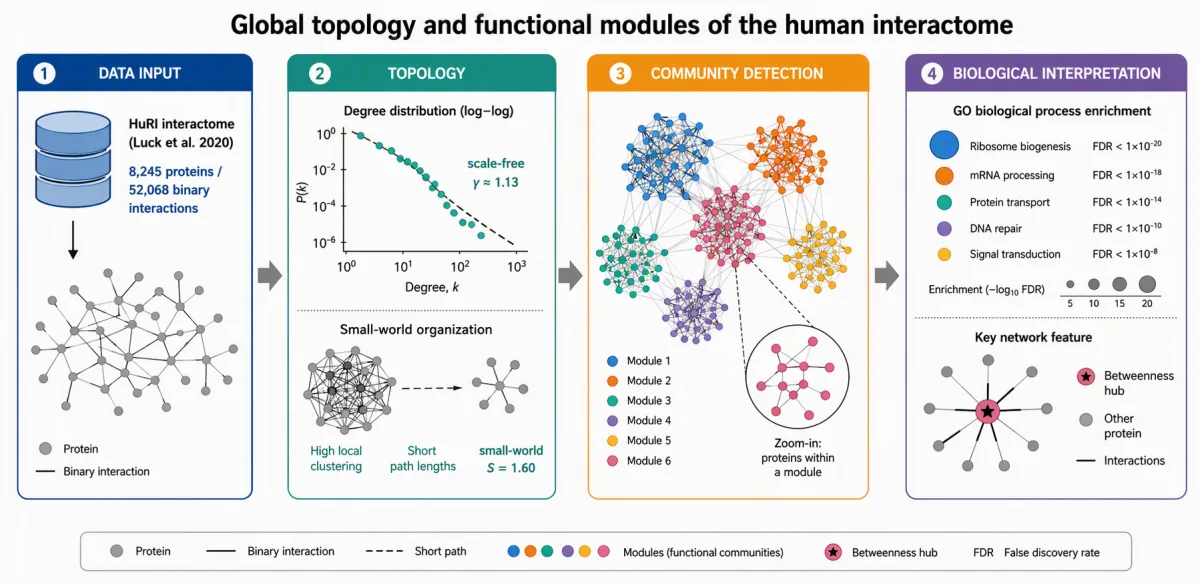
针对人类蛋白质二元相互作用网络(Interactome)全局拓扑特征与功能模块映射关系尚缺乏系统量化评估的问题,本研究基于人类参考相互作用组(HuRI)图谱,在纯拓扑分析视角下对包含8,245个蛋白质及52,068对二元相互作用的网络进行了图论与复杂网络分析。研究证实HuRI网络具有重尾无标度分布、小世界特性及高模块化结构,并成功在无先验功能标签的前提下恢复出包括细胞骨架、跨膜运输、转录调控与剪接体组装在内的10大核心细胞功能模块,为理解人类细胞分子拓扑逻辑提供了基准图谱。

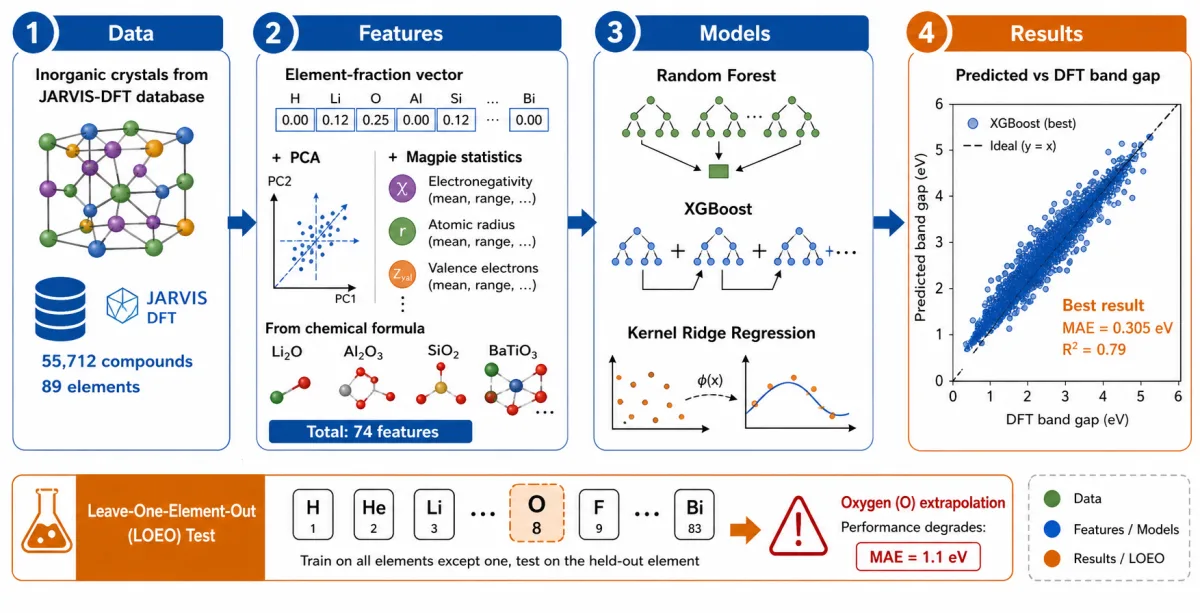
针对高通量材料筛选中密度泛函理论(DFT)带隙计算成本高昂且依赖已知晶体结构的问题,本研究基于JARVIS-DFT数据库中的55,710种无机化合物,仅利用化学成分信息构建了74维特征向量,对比了随机森林、XGBoost与核脊回归(KRR)的预测性能,并系统开展了留一元素(Leave-One-Element)外推敏感性分析。研究表明,随机森林在随机划分下实现了0.305 eV的最佳平均绝对误差(MAE),但留一元素实验(特别是氧元素剔除)揭示了模型在面对化学外推与标签分布偏移时的严重性能衰退。

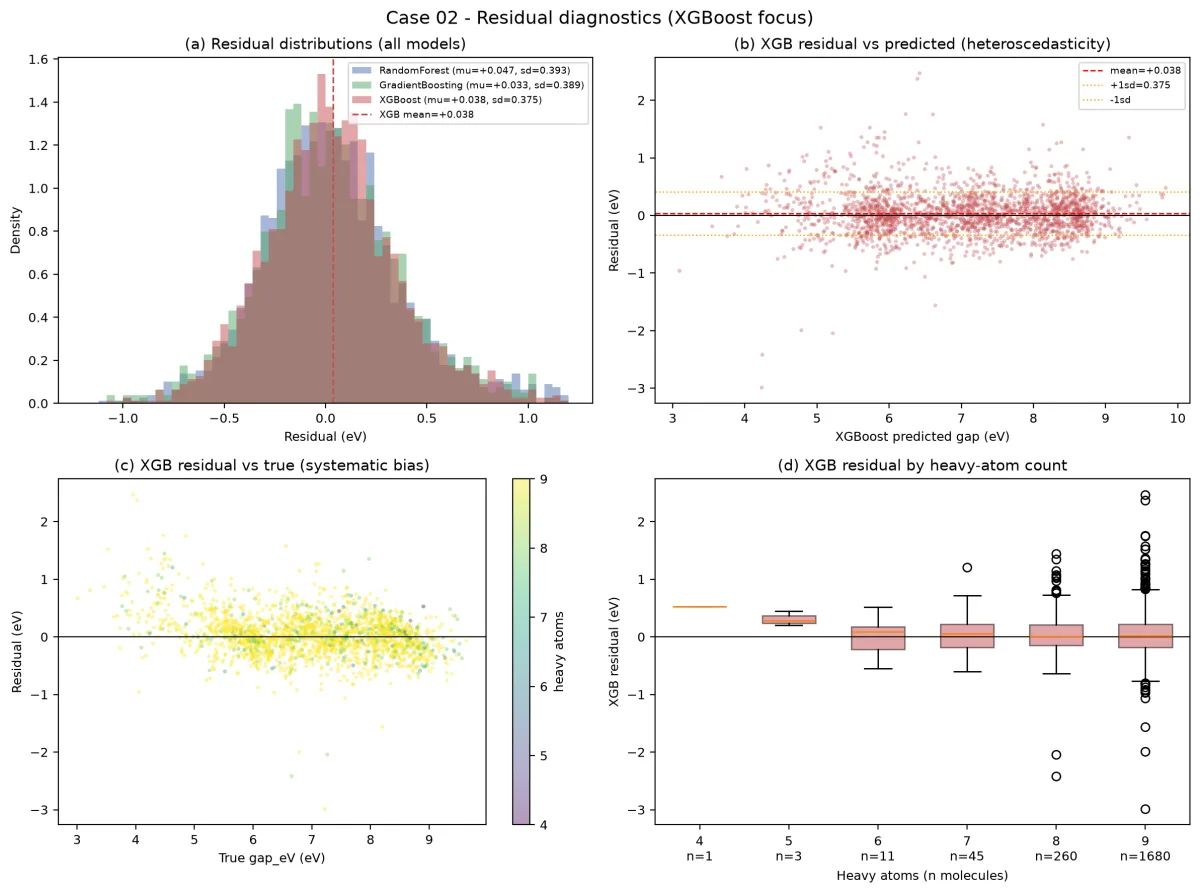
针对量子化学前沿轨道能隙(HOMO–LUMO能隙)的高精度计算(如密度泛函理论DFT)难以直接扩展至超大规模分子库高通量筛选的问题,本研究基于包含约13.4万个有机小分子的QM9数据集,建立了一套仅依赖纯2D分子结构与CPU算力的传统机器学习预测方案。在严格按Murcko骨架分割的20,000个分子子集上,XGBoost模型实现了0.269 eV的测试集平均绝对误差(MAE)与0.914的拟合优度($R^2$),证明了传统描述符与集成学习在无需3D结构与GPU算力的前提下,即可接近杂化DFT参考误差的水平。

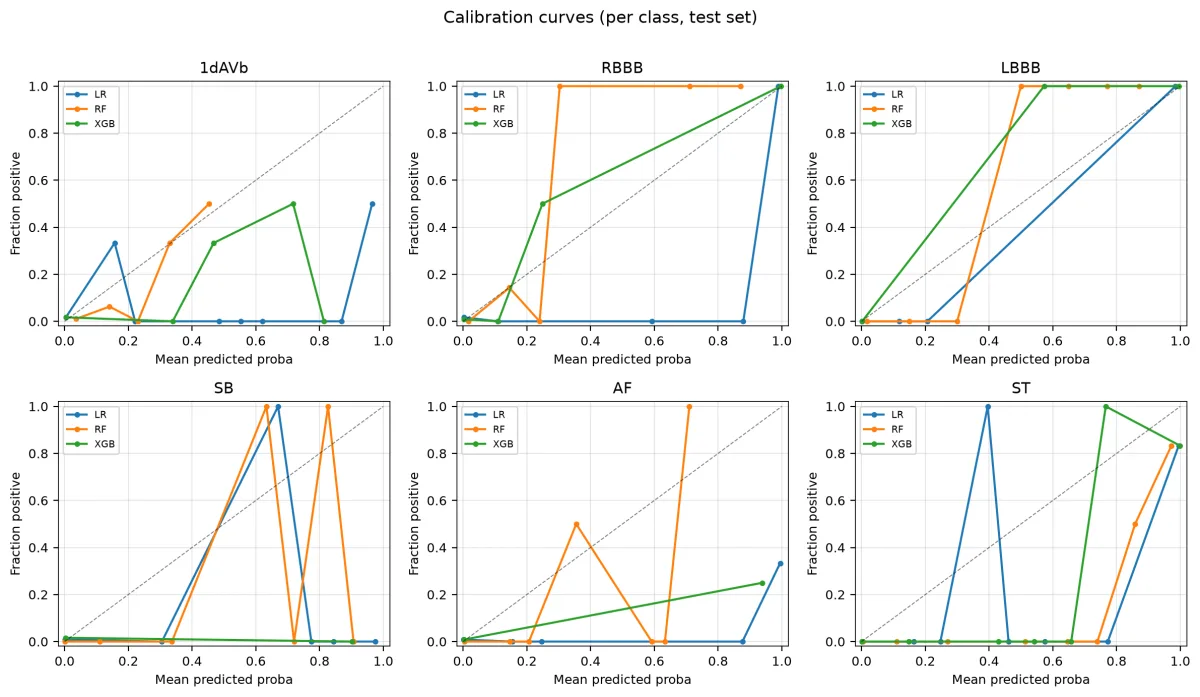
针对深度学习心电图诊断依赖算力且缺乏机制可解释性的问题,本研究在严控数据泄漏的跨患者协议下,基于827例12导联心电图提取可解释生理特征,利用经典机器学习实现了6类心律失常分类。随机森林模型在测试集上取得0.977的Macro AUROC与0.621的Macro F1,证实纯CPU运行的手工生理特征即可提供强鉴别力与临床可审计的决策链路。

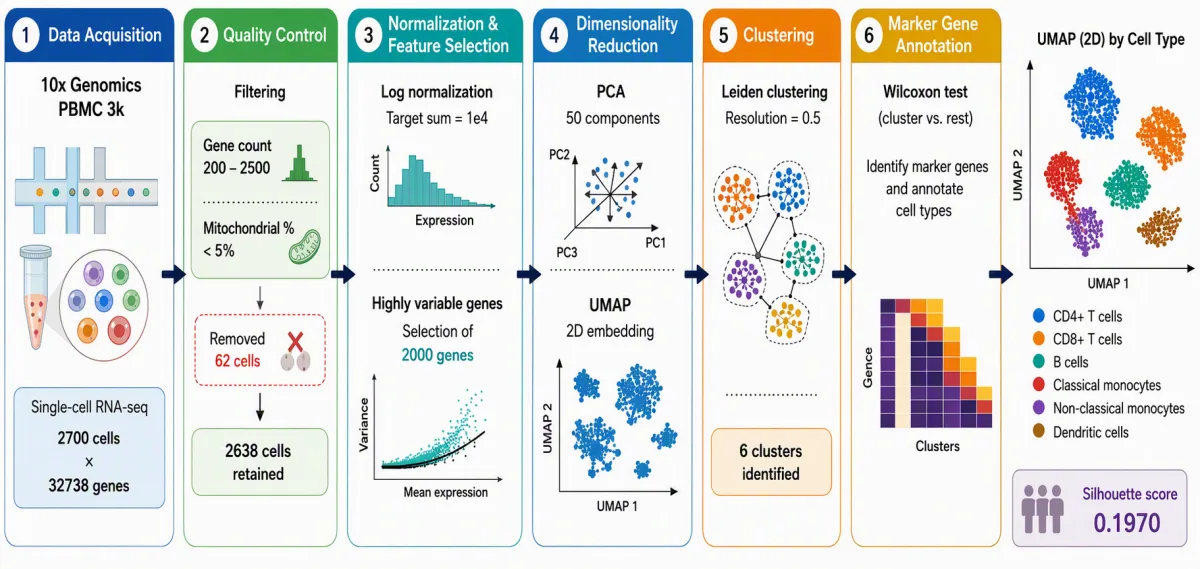
针对单细胞RNA测序(scRNA-seq)数据普遍存在的高维、稀疏、高噪声及细胞异质性识别难题,本研究以10x Genomics PBMC 3k数据集(约2,700个细胞 × 32,738个基因)为对象,系统搭建并完整验证了一套基于Scanpy框架的端到端标准单细胞分析流程。流程涵盖数据质控、对数归一化、高变基因筛选、PCA降维、Leiden图聚类、UMAP可视化及差异标记基因(Marker)鉴定。最终成功识别出6种主要免疫细胞亚群,并在PCA空间取得了0.1970的轮廓系数,为PBMC类单细胞转录组数据处理提供了具备可复现性与生物学合理性的标准技术参考。

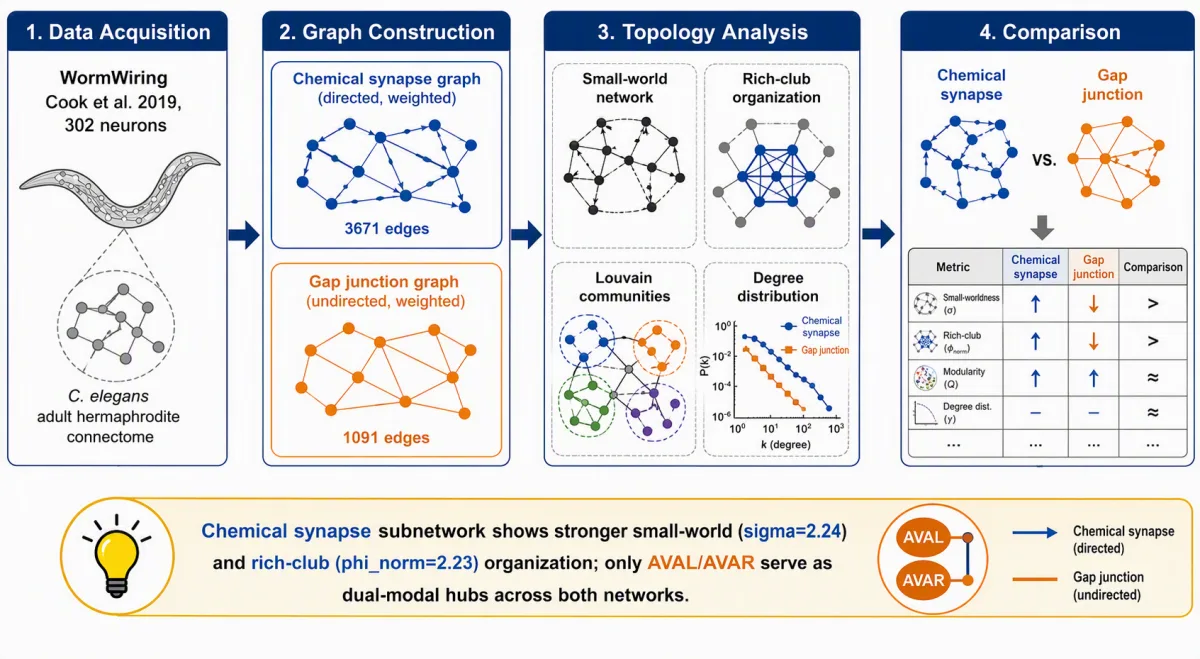
秀丽线虫成年雌雄同体神经系统是目前唯一步线层级的全动物完整神经连接图谱,包含定向化学突触与双向电(间隙连接)突触两种本质不同的信号传递通道。基于Cook等(2019)发布的 *WormWiring* 数据集,本研究首次在同等基准下对302个神经元构成的化学突触子网(定向加权图,3,671条边)与电突触子网(无向加权图,1,091条边)开展了系统拓扑对比。研究表明,虽然两子网均具备显著的小世界特性($\sigma_{\text{chem}}=2.24$, $\sigma_{\text{gap}}=2.74$),但在拓扑组织原则上发生剧烈分化:化学突触网络呈现出更密集的定向前馈结构与高度集中的富人俱乐部核心(峰值 $\varphi_{\text{norm}}=2.23$,由9个中间神经元主导);而电突触网络则呈现更强的权重异质性、更高的模块化程度($Q=0.68$ vs 0.51)与更分散的模块划分。全文仅有 AVA 倒退指挥神经元对(AVAL/AVAR)同时具备双模态枢纽地位,揭示了化学定向路由与电信号局部同步在神经系统中的功能互补性。
从系统定位、执行方式,到能力边界、部署与交付。