
外周血单核细胞RNA测序标准分析流程技术
针对单细胞RNA测序(scRNA-seq)数据普遍存在的高维、稀疏、高噪声及细胞异质性识别难题,本研究以10x Genomics PBMC 3k数据集(约2,700个细胞 × 32,738个基因)为对象,系统搭建并完整验证了一套基于Scanpy框架的端到端标准单细胞分析流程。流程涵盖数据质控、对数归一化、高变基因筛选、PCA降维、Leiden图聚类、UMAP可视化及差异标记基因(Marker)鉴定。最终成功识别出6种主要免疫细胞亚群,并在PCA空间取得了0.1970的轮廓系数,为PBMC类单细胞转录组数据处理提供了具备可复现性与生物学合理性的标准技术参考。
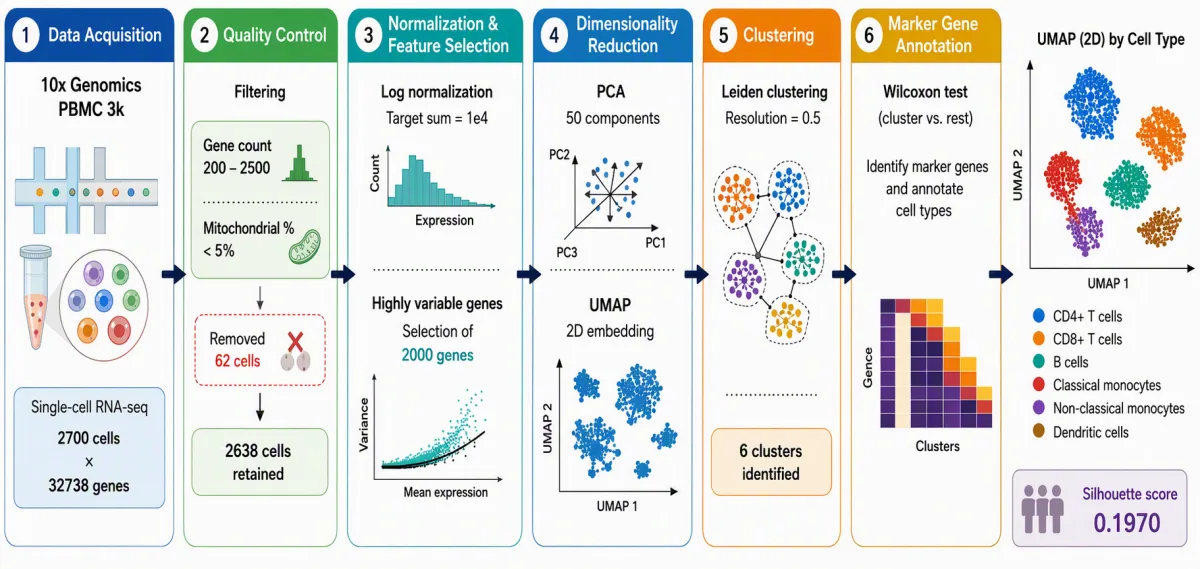
研究问题
单细胞RNA测序技术能够在单细胞分辨率下揭示组织内的细胞异质性与转录动态。然而,由于微流控液滴捕获过程中的技术噪声、死细胞/空液滴污染、双细胞(Doublets)干扰以及测序深度差异,原始数据无法直接用于细胞亚群划分与生物学解释。如何在保障细胞质量的同时精确剔除干扰信号?如何选择最适的分辨率参数以兼顾聚类稳定性与微小亚群识别?以及如何通过标准化基因差异检验实现无偏的细胞类型注释?本研究的核心问题是:建立一套标准化、参数可审计且高度可复现的scRNA-seq分析流水线,并在经典PBMC 3k数据集上验证其在细胞质控、降维聚类与标记基因识别方面的可靠性。
研究路径
为回答上述问题,研究团队基于Scanpy平台设计了包含六个顺序步骤的标准分析框架: 1. 数据质控与过滤:以线粒体基因读占比 <5\% 及检出基因数 \in [200, 2500] 为双重阈值剔除低质量与死细胞,随后过滤零细胞表达基因; 2. 归一化与高变基因选择:采用总表达量归一化(target_sum=1e4)与对数化(log1p),保存全基因表达层至 adata.raw;选用 seurat 方法筛选前2,000个高变基因(HVG),并对总计数与线粒体占比进行回归缩放; 3. 降维与图聚类:构建50维PCA矩阵,基于前40个主成分构建 k=10 的最近邻图,运行Leiden算法(默认分辨率0.5,固定随机种子42),并利用UMAP进行二维可视化; 4. 分辨率敏感性分析:评估分辨率在 \{0.3, 0.5, 0.7, 1.0\} 下的聚类数、轮廓系数(Silhouette Score)、成对调整兰德指数(ARI)与归一化互信息(NMI),建立最佳分辨率筛选准则; 5. 差异表达与细胞类型注释:利用Wilcoxon秩和检验在未缩放的 adata.raw 上提取各聚类的特异性标记基因,结合经典免疫标志物(CD3D, CD79A, LYZ, FCGR3A, NKG7, FCER1A)完成细胞类型定量注释; 6. 综合评估与结果导出:全面计算方差解释比、每簇基因数分布及轮廓系数等指标,完成流水线验证。
核心发现
研究结果显示,该分析流程能够精准过滤技术噪声,在最优化分辨率下实现高度契合免疫学先验的细胞亚群划分。
- 严格质控有效提纯高质量细胞群:质控过滤移除了62个低质量细胞(保留2,638个细胞)与2,923个低覆盖基因(保留13,656个表达基因)。质控后线粒体读占比均值为2.12%(最大4.99%),基因数中位数为820个,有效排除了离群死细胞与假阳性双细胞。
- PCA与Leiden算法实现最佳聚类分割:PCA前40个主成分累计解释12.04%的方差。在邻接图上运行Leiden算法(分辨率0.5),获得6个细胞聚类,在PCA空间取得 0.1970 的轮廓系数。分辨率敏感性分析证实0.5分辨率在避免产生 <30 细胞的微簇与保持高轮廓系数之间取得了最佳平衡。
- 标记基因精确鉴定6种外周血免疫细胞亚群:基于Wilcoxon秩和检验(p_{\text{adj}} \ll 10^{-12}),结合经典与扩展标志物成功注释出:CD4^+ T细胞(44.92%)、经典单核细胞(CD14^+, 18.12%)、CD8^+ T细胞(16.22%)、B细胞(CD79A^+, 12.93%)、非经典单核细胞(CD16^+, 6.41%)及树突状细胞(DC, 1.40%),各亚群在UMAP空间呈现高度分离的拓扑分布。
总结而言,本论文成功验证了基于Scanpy的标准单细胞分析流程在PBMC数据处理中的卓越性能,证明了“质控-HVG-PCA-Leiden-Wilcoxon”组合策略能够无偏、高精度地还原外周血免疫细胞图谱。
适用边界
本研究结论的推导与应用受限于特定条件。首先,测试数据为单供体、无批次效应的预处理PBMC 3k数据集,流程中未包含显式的多样本批次校正算法(如Harmony、MNN)。其次,树突状细胞亚群(簇5)细胞数量较少(37个细胞),虽然标志物表达特征显著(FCER1A, HLA-DR),但受限于样本规模,其置信度评估为中等,无法进一步细分为cDC1/cDC2/pDC等亚型。此外,本流程未包含专门的双细胞预测软件(如DoubletFinder),仅靠基因数上限间接过滤。
基于现有证据,该研究能够支持在单样本、无复杂批次干扰的PBMC及类似人外周血免疫细胞scRNA-seq数据中进行标准的细胞分群、标记基因提取与大类细胞注释;但尚不足以支持对复杂跨批次数据集、高度连续的分化轨迹以及极其罕见的细胞亚群(<0.5\%)进行深度的自动化细分与动态建模。