
基于成分的DFT形成能机器学习预测及特征重要性与留元外推基准分析
本研究构建了一套纯成分特征驱动的轻量级 CPU 级机器学习基准,旨在无需晶体结构信息的条件下评估材料形成能(ΔEform)的预测性能。研究系统对比了随机森林(RF)、XGBoost(XGB)与 RBF 核脊回归(KRR)在随机插值与留元外推(LOO)情境下的表征能力,揭示了树集成模型与核回归模型在化学空间外推上的根本差异。
研究问题
材料基因组学与高通量材料筛选高度依赖基于密度泛函理论(DFT)的形成能计算,但 DFT 在处理超大搜索空间时计算昂贵。虽然机器学习模型(如晶体图神经网络 CGCNN、M3GNet)已取得显著进展,但它们依赖已知三维晶体结构,限制了在结构未知新材料发现中的应用。现有基于纯成分的轻量级模型通常仅在随机划分的测试集上评估插值性能,忽略了对未包含元素的外推能力评估。本研究旨在建立透明的纯成分基准,回答在无结构信息输入下,不同算法模型在随机划分与留一元素外推场景中的预测上限及泛化边界。
研究路径
作者设计了包含特征工程、随机分割基准与留一元素外推测试的完整分析路径。研究基于 Materials Project(Matbench matbench_mp_e_form)的数据集,提取了 50,000 个无损材料样本(形成能均值 -1.409 eV/atom,标准差 1.163 eV/atom)。
数据特征构建为 300 维复合成分特征矩阵,包括:
- 元素周期表 118 维元素原子分数
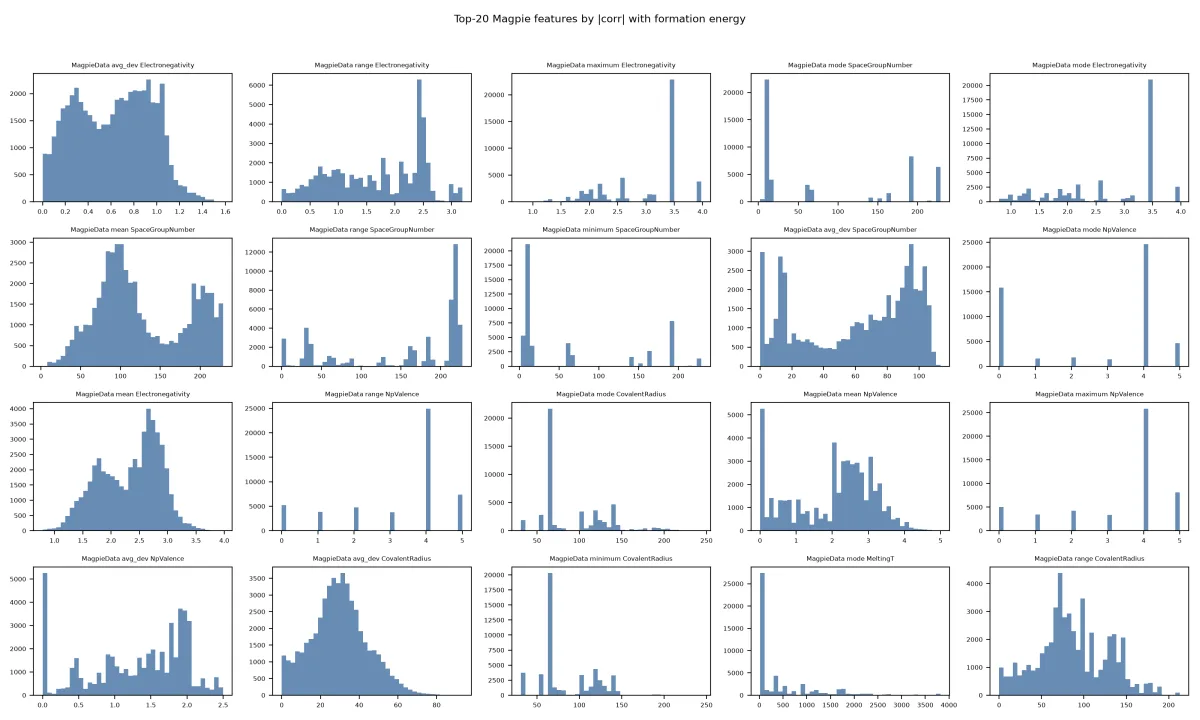
- 132 维 Magpie 元素物理化学性质统计量(均值、最大值、极差、平均绝对偏差等)
- 26,509 维 1–3 体高阶交叉特征(经 PCA 降维至 50 维,累积方差贡献率 92.3%)。
数据分割包含两种方案:一是 80/10/10(40,000/5,000/5,000)的随机划分用于评估插值能力;二是针对 O、Fe、Li 三种代表性元素构建留一元素外推划分(训练集剔除含该元素的所有化合物,测试集仅包含含该元素的化合物)。模型训练对比了 Random Forest、XGBoost 与通过 RBF 核拟合的 Kernel Ridge Regression。
核心发现
实验表明,树集成模型在插值精度与外推鲁棒性上全面优于核回归模型,且物理化学特征(如电负性)主导了预测过程。
在随机划分下,随机森林取得了最佳预测精度。随机森林在测试集上达到了 MAE 0.1502 eV/atom(R² = 0.9378),XGBoost 为 0.1653 eV/atom(R² = 0.9382),KRR 为 0.2042 eV/atom(R² = 0.8997);所有模型在氧化物子集上的预测精度均显著高于非氧化物。
置换重要性分析显示,Magpie 的电负性平均绝对偏差是最关键特征。在三大模型中,Magpie avg_dev Electronegativity 的重要性得分高居第一(RF 0.672, XGB 0.478, KRR 0.576),体现了化学键极性对形成能的主导作用。
留一元素外推揭示了模型机制差异:树模型保留外推能力,而 RBF 核模型外推完全失效。在移除最常见元素 O(占样本 ~50%)的外推测试中,RF 和 XGB 的 MAE 仅上升约 3 倍(0.5296 与 0.5104 eV/atom),仍保持正 R²(0.27–0.38);而 KRR 的 MAE 暴增 4.9 倍(1.0014 eV/atom),R² 崩溃至 -1.733。而在元素 Fe 外推中,树模型的 MAE 甚至与随机划分持平(RF 0.1407 eV/atom, R² = 0.950)。
论文贡献在于系统证明了基于成分的树模型在跨化学空间外推时,能够通过隐式利用 Magpie 物理化学特征的关联完成外推,而 RBF 核因在未见元素零向量区域缺乏支持集而失效。
适用边界
本研究结论受到以下条件与局限的影响。首先,数据集未包含 energy_above_hull(凸包上方能量),因此稳定性分析采用了 Eform < 0 的代用指标,而非严格的热力学凸包稳定性判断;其次,为保持计算可行性,KRR 模型仅在 10,000 个训练子样本上拟合;第三,纯成分特征无法区分同分异构体与不同晶相的多晶形材料(如石墨与金刚石)。
因此,该轻量级基准适用于材料筛选早期的高通量成分初筛与未知元素组合的外推趋势预测,但无法直接代替包含三维晶体结构信息的精细 DFT 弛豫计算与热力学相图稳定性评估。